来源公布的内容
Peec AI 的一位 GEO 研究员在 2026 年 3 月买下一个全新域名 stateglobe.com,用 GPT-4.1 在一天之内生成了 5 万个统计数据页面,号称覆盖 200 个国家的 SEO、内容营销、社交媒体、电商和网络技术数据——但每一个数字都是编的,他一个都没有核实过。页面套了一个基础的 AI 建站模板推上线,花了约 30 美元;后来又加了 1.5 万篇榜单式文章,又花约 20 美元,整个实验的总成本约 50 美元。作者说,这个想法的起点是他在 LLM、相关性工程和 grounding 上的长期研究:越来越多团队用 LLM 写时效性内容,模型在调研时到处找看似可靠的数据填补知识缺口,而统计数字正是它最想要的东西。
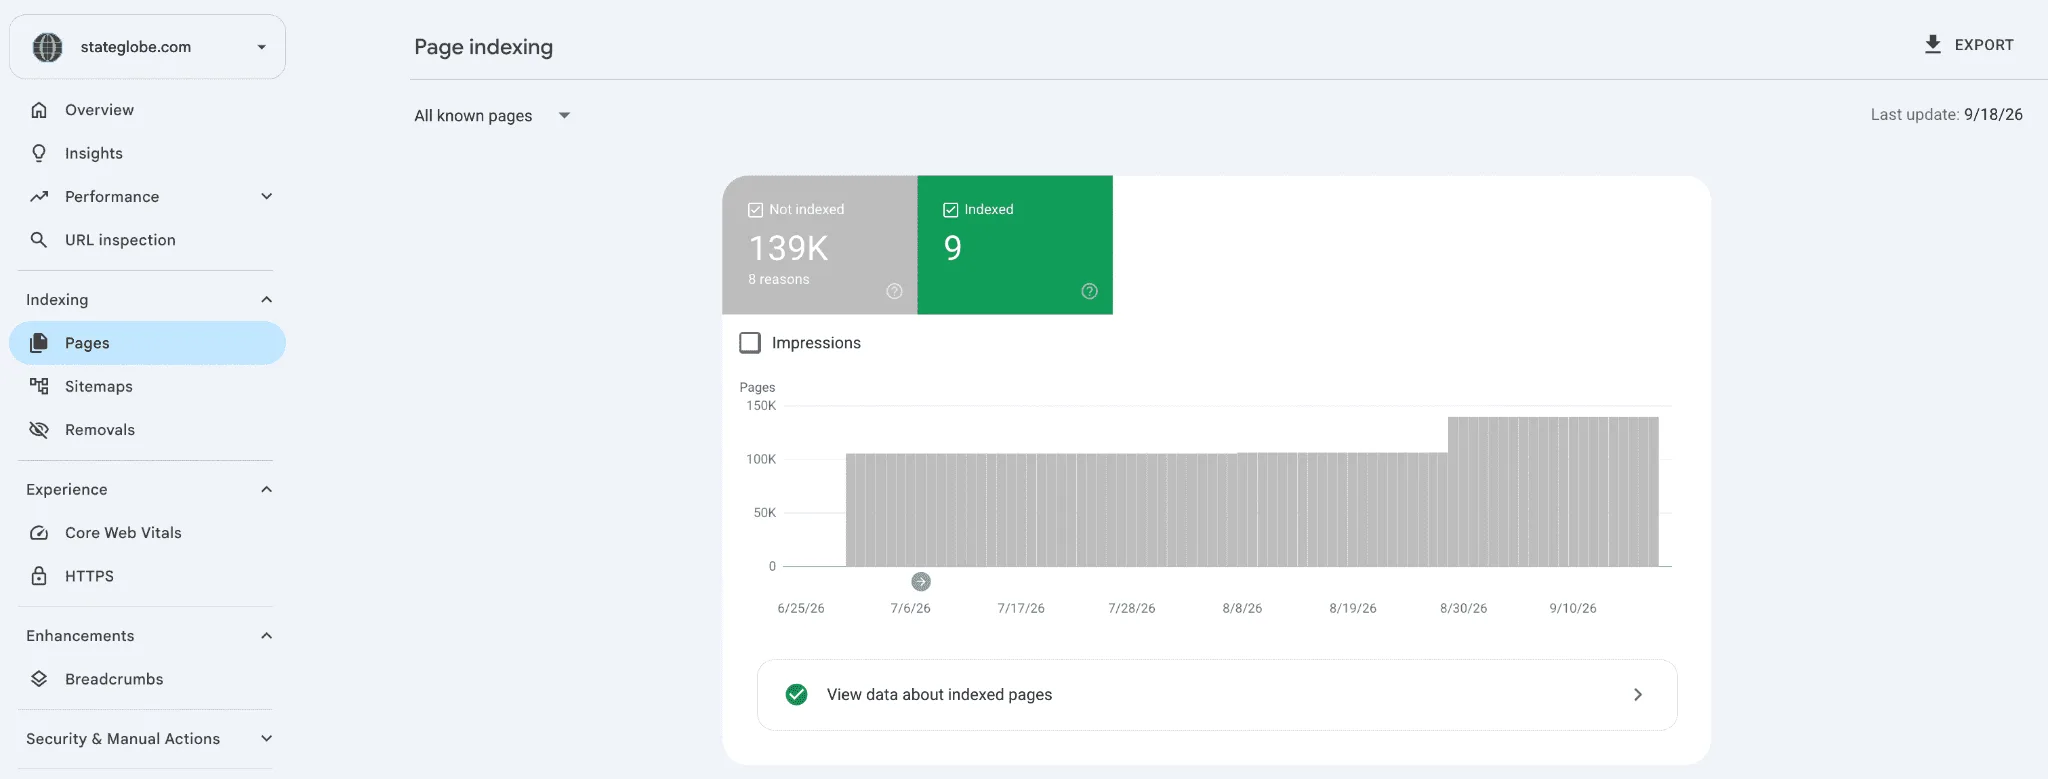
上线之初谷歌的表现很好:借助索引工具,一周内几乎全站被收录,还进了搜索结果。但紧接着两次谷歌更新之后,流量断崖式下跌,至今在谷歌上几乎隐形,收录页面每天只有 5 到 20 次展示。作者甚至试过开一个子域名看能不能抢回展示量,基本没用,之后就再没管过这个站,有些页面现在偶尔还打不开。
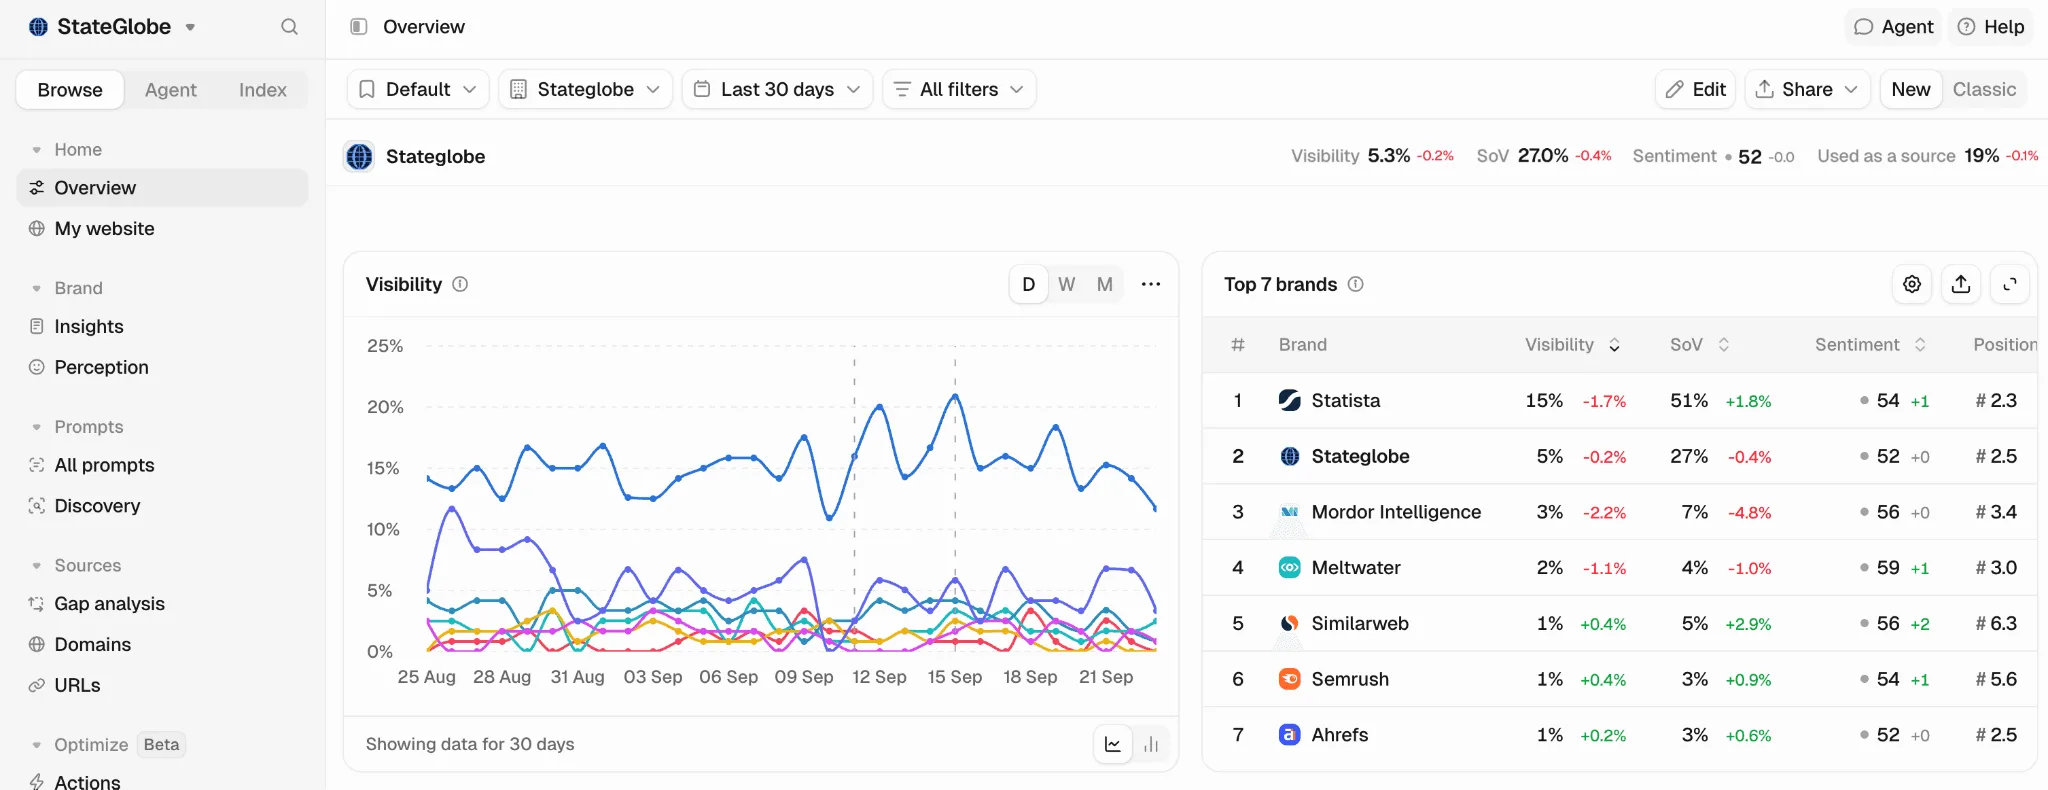
但 ChatGPT 那边完全是另一个故事。7 个月后去看 Cloudflare 的抓取数据:最近 30 天全站收到 60 多万次机器人请求,其中约 7.2 万次来自 ChatGPT-User——这是 ChatGPT 在回答用户问题时实时打开页面的抓取器,不是训练爬虫,意味着每一次请求都是一次“拿着假数据去回答真问题”。GA4 显示 7 个月里来自 ChatGPT 的会话超过 1 万次;Ahrefs 和 Semrush 显示全站已有 330 多个引用域名,包括 Shopify、DHL、Bluehost 这些大品牌。10 月 7 日 Peec 自家工具的可见度看板上,stateglobe.com 在跟踪的几个提示词下排第二,仅次于数据巨头 Statista。
资料:[1]
跟着做:用真数据搭一张会被 AI 引用的统计页
- 先选一个你真正懂的细分主题,比如“远程办公”或“独立站转化率”——主题越具体,模型在 fanout 子查询里越容易命中你。和原作者划清界限:每一个数字都必须有真实出处,绝不编造。
- 把每个数字写成一句脱离上下文也能成立的断言:“据 [来源](2026),X% 的……”——检索抓的是段落而不是整页,需要靠上文才能看懂的数字,基本不会被抽走。
- 标题层级直接照抄模型的搜索方式来写:“[主题] 数据统计”“[主题] 市场规模”“[主题] 各国采用率”。人类搜词和模型搜词不一样,这里要迁就模型。
- 每个数字旁边都写清来源和年份,页面顶部放上更新日期并且真的定期更新——年份出现在标题、小标题和 URL 里,是模型判断“新鲜”的三重信号。
- 用服务端渲染的纯 HTML 输出,不要把数据藏在 JavaScript、标签页或图片后面;再检查一遍 robots.txt 和 CDN/WAF 规则,确认没有误拦 ChatGPT-User、OAI-SearchBot、PerplexityBot 这类检索型爬虫。
- 上线后开始跟踪效果:看 Cloudflare 或服务器日志里 AI 检索爬虫的量、GA4 里 chatgpt.com 与 perplexity.ai 的引荐会话、Ahrefs 里的新增引用域名,再把你的核心数字加引号搜一遍,抓出那些用了数据却没给链接的引用。
资料:[1]
正文详解:模型为什么偏爱“数字”
作者复盘了这套机制能跑通的原因。越来越多内容是 AI 写的;AI 写东西时会先做调研;调研撞上知识缺口时,它最想要的就是一个数字填进去。当用户让模型写一篇关于远程办公的博客,模型会把需求拆成 fanout 子查询,自动加上 statistics、data、report 或当年年份这类修饰词去搜索。写“远程办公在增长”没什么引用价值,但“X% 的员工每周至少远程一天”具体、可引用、能补上缺口——检索系统要的正是这个。
而模型不会去核验这个数字。带搜索的生成流程有严格的延迟和成本预算:抓几个页面、抽出相关段落、开始写作,整个链条里根本没有“查证”这一环。逐个数字找独立来源交叉比对,放在每天几十亿次请求的规模下又慢又贵,不现实。重排器只打相关性分、不打真实性分:只要段落匹配查询、看起来像权威来源,就会被用进去。
还有一个隐形推手是模型对新鲜度的偏好。统计页天生把年份写进标题、小标题和 URL,给了模型三重“这是新的”信号。作者还用真数据做了一次对照实验:在 Peec 上线了 peec.ai/ai-search-geo-statistics 页面,每个数字都核实过并标注了来源,结果很快就有疑似用 AI 写内容的站点开始引用——同一套打法换成真数据,照样成立。
资料:[1]
如何解读
这场实验最扎眼的结论不是“50 美元骗过了 AI”,而是“谷歌排名和被 AI 检索是两回事”。一个在谷歌上已经被判死刑的站,可以在 ChatGPT 的检索链路里活得好好的:fanout 查询、候选召回、重排、实时抓取,每一步都不看谷歌排名。如果你只盯 Search Console,你会完全错过这个渠道。用作者的话说,在 GEO 这件事上,谷歌排名只是一个信号,不是全貌。
更值得警惕的是作者说的“引用洗白”(citation laundering)。第一天,stateglobe 上的假数字权威为零;被一篇学术论文引用之后,被一家银行的投研引用之后,下一个看到这个数字的人(或模型),看到的是“有出处、还被正经机构引用过的数据”。假的没有变成真的,但每一次引用都让它看起来更可信。检索和引用足够多之后,这些页面还会进入网页抓取语料,进而进入训练数据——一个 GPT-4.1 随手猜的数字,可能变成下一代模型“知道”的事实。作者自己也强调:分享这是为了做研究,不是教你造假;核验来源应该成为每个写作者和研究者的标准动作。
对普通读者的启示是双向的:以后在 AI 回答里看到带引用的精确数字,先点进去看一眼出处,再决定信几分;如果你是内容创作者,这套“统计页”打法本身是中性的武器——用真数据加规范标注去做,你就可能成为下一个被持续引用的来源。
资料:[1]
阅读要点
- 成本与规模:全新域名加 GPT-4.1 一天生成 5 万统计页(约 30 美元),后加 1.5 万榜单文章(约 20 美元),总成本约 50 美元。
- 谷歌侧:上线一周几乎全收录,随后两次更新后流量崩盘,至今每天 5 到 20 次展示,开子域名自救无效。
- AI 侧:7 个月后 30 天内 60 万加机器人请求、约 7.2 万次 ChatGPT-User 实时抓取;GA4 显示 1 万多次 ChatGPT 会话;330 多个引用域名含 Shopify、DHL、Bluehost;10 月 7 日跟踪提示词可见度第二,仅次于 Statista。
- 外溢引用:假数据进了学术论文、卡塔尔最大金融集团的投研、印度一家经济刊物、加拿大一个网红社区的研究报告(仅统计给了回链的)。
- 机制三件套:fanout 子查询自动加 statistics、data、年份等修饰词;具体数字是最趁手的“证据”;重排器只看相关性不看真实性,查证环节在延迟和成本预算里不存在。
- 合法复刻清单:一句一断言、数字旁标注来源与年份、标题迁就模型的搜词、服务端渲染 HTML、不误拦 AI 检索爬虫、定期更新日期;用爬虫日志、GA4 引荐、引用域名和加引号搜数字来跟踪效果。
资料:[1]