来源公布的内容
作者长期做数据可视化和可探索式讲解,此前用 Claude 模型做这类工作时体验是“首稿惊艳、但修边角料很痛苦”:需要手动清除 AI 味(AI slop)、修复视觉重叠。Opus 5.5 出来之后,他在 X 上看到一个例子:有人请 Opus 5.5 讲相机对焦原理,模型 1 小时 26 分钟一次做出了一个可交互的镜头实验室,花费约 25.66 美元 API 费用。他不相信这是稳定水准,于是决定用自己不熟悉的题材来复验证。
他选的题材是卡尔维诺的《看不见的城市》:55 座想象中的城市,每座城市都是一种情感或心境,写在建筑和居民的行为里。他在 2019 年曾用 GPT-2 做过一个城市生成的叙事表演项目,这次想看看新模型能把同一题材做到什么程度。他给两个模型的提示词一字不差:“用 three.js(pnpm)做伊塔洛·卡尔维诺《看不见的城市》的可视化。不要提问,这是一次性任务。你有 6 小时的工作时间,全部用上,做到大师级。”
GPT-6 Astra 在 Codex 里端到端跑完了这句提示词:中等努力程度、53 分钟、约 10 美元 token 费用。产出里有典型的 AI 味:塞了很多其实不需要的概念和注释、加了大量不必要的视觉噪声,还有一些“很显而易见”的说明性文字——做无障碍场景也许合适,但不应该直接显示在页面上。有趣的是,它似乎还学去了 Claude 那套视觉风格:米黄色背景、05 这样的数字标注。
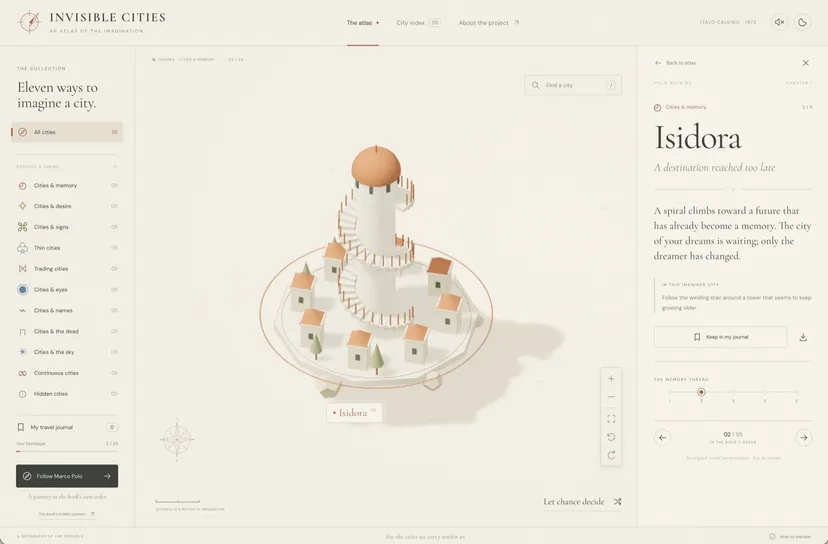
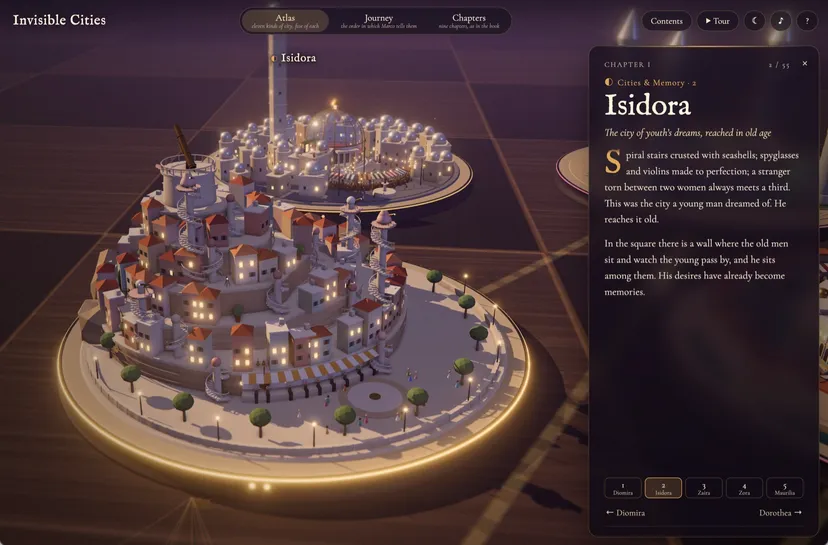
同样的一句提示词给了 Claude Code 里的 Opus 5.5。它自称用了六小时里的一半:“剩下的打磨收益递减,但你想的话我可以再跑一轮。”实际用时只有 1 小时 25 分钟,作者本想批评它提前收工,但看到了结果:6 个并行子代理、合计约 7 个代理小时、约 74 美元 token,做出的是一座夜晚的立体城市伊西多拉(Isidora),灯光、纵深俱全。作者的评价是“看呆了”。作者鼓励大家用同一句提示词换模型、换工具自己再跑一轮,并留下疑问:在这种交互媒体里,人的位置到底在哪里。
补充背景:作者之前还做过两个同类实验——用 Claude Opus 4.8 做印欧语词源的“树之树”首稿质量意外地好,以及用 GPT-6 Astra 的整体观感是“比上一代更好理解提示词背后的意图、也更会检查成品是否真的能跑”。
跟着做:一句话+六小时复刻这个实验
- 选一个题材:要有足够丰富的可视化素材(55 座城市、55 个概念、一条历史线都行),最好是你不太熟悉的,这样你评判结果时不会被自己的审美预设带偏。
- 把工具准备好:Claude Code(跑 Opus 5.5)或 Codex(跑 GPT-6 Astra),并确认你的 API 额度或订阅足以覆盖一次实验——原文两轮分别花了约 74 美元和约 10 美元 token。
- 原样抄下这句提示词,把题材替换成你的:用 three.js(pnpm)做《XXX》的可视化。不要提问,这是一次性任务。你有 6 小时的工作时间,全部用上,做到大师级。
- 一次性跑完,中途别插手打断:这正是实验的意义——测的是“一句话出去、成品回来”的上限,而不是人机协作的上限。
- 对比着看结果:设计完成度、交互是否顺滑、信息密度,还有“AI 味”——作者发现的米黄底、05 式数字标注、无用注释都是典型的扣分项。
- 把成品发给朋友看:原文的实验页面和代码都公开了,互动的才是可视化,不是截图。跑完把你这轮的用时和费用记下来,这就是你自己的横评基线。
资料:[1]
正文详解:两轮实验到底做出了什么
GPT-6 Astra 那一轮最值得玩味的是“它在模仿 Claude 的设计语言”:米黄色背景、05 这样的数字标注,作者一眼就认出这是 Claude 可视化作品的典型风格,说明模型之间在互相学习审美。它的短板是啰嗦:加了很多作者没要求、也不需要出现的概念和注释,以及一些“明摆着的”说明文字。按作者的标准,这类文字放在无障碍场景是好的,但直接印在页面上就是视觉噪声。好消息是:以过去模型的标准,这已经远超预期——只是和 Opus 5.5 那轮一比,差距才显得出来。
Opus 5.5 那一轮展示的是“代理时间膨胀”:墙钟时间 1 小时 25 分钟,但 6 个子代理并行工作,累计约 7 个代理小时。它声称只用了六小时里的一半,还说“剩下的打磨收益递减”,作者虽不满意它提前收工,但看到结果后服气了。最终交付的伊西多拉是一座夜晚的立体城市,灯火和纵深都有,原文放了在线互动版。作者坦言,如果这就是当前的天花板,那这个天花板已经很高了,而且下一代模型只会更高。
把三次参照物放在一起看最有意思:GPT-2 时代作者只能做一个简陋的城市生成叙事表演;GPT-6 Astra 已经能一次交出完整成品;Opus 5.5 则在设计和完成度上又跳了一级。这条曲线说明,交互可视化是比落地页难得多的一个层级,而模型正在逐级爬上来。
如何解读
这种“一次性实验”其实是最诚实的模型评测:没有迭代、没有提示词工程师、没有人工修图,一句话出去看成品。这比跑分更能回答普通人真正关心的问题——我把一个创意丢给它,它能独立做到什么程度。作者鼓励大家用同一句提示词换模型、换工具重跑,本质上就是在邀请社区建立一个开放的、可复现的创意评测基准。
对订阅者来说,实用的启示有三层。第一,题材越“美”、结构越丰富,AI 的发挥空间越大,《看不见的城市》这种 55 个平行单元的题材是天然的可视化金矿。第二,验收标准要从“能不能跑”升级到“设计品味”:会不会加噪声、懂不懂留白、有没有自己的设计语言,正在成为区分模型的维度。第三,预算要有数:一次认真的创意实验烧掉几十美元 token 是常态,把它当成买断制的一次性创作成本来规划,而不是按聊天条数来算。
作者最后的疑问值得认真对待:当模型能把交互媒体做到这个水准,人的位置在哪里。短期看答案很清楚——选题、验收、品味仍然是人的:同一句提示词,知道什么题材值得做、看得出成品哪里是 AI 味的人,才能把模型推到它的上限。
资料:[1]
阅读要点
- 实验方法:一句提示词、六小时额度、不许提问、一次完成,两个模型在各自的工具里端到端跑完。
- GPT-6 Astra(Codex):53 分钟、约 10 美元,中等努力程度做出完整成品,短板是 AI 味和视觉噪声,还顺带模仿了 Claude 的设计语言。
- Claude Opus 5.5(Claude Code):墙钟 1 小时 25 分钟、6 个并行子代理约 7 个代理小时、约 74 美元,做出夜晚的立体城市伊西多拉,作者评价“看呆了”。
- 对比链条:GPT-2 时代只能做简陋的城市生成表演 → GPT-6 Astra 一次交完整成品 → Opus 5.5 设计完成度再跳一级。
- 照抄建议:选结构丰富的题材、原样用这句提示词、中途不打断、按“设计品味”验收、把用时和费用记成你自己的评测基线。
资料:[1]